先说一个很多人没注意到的细节。
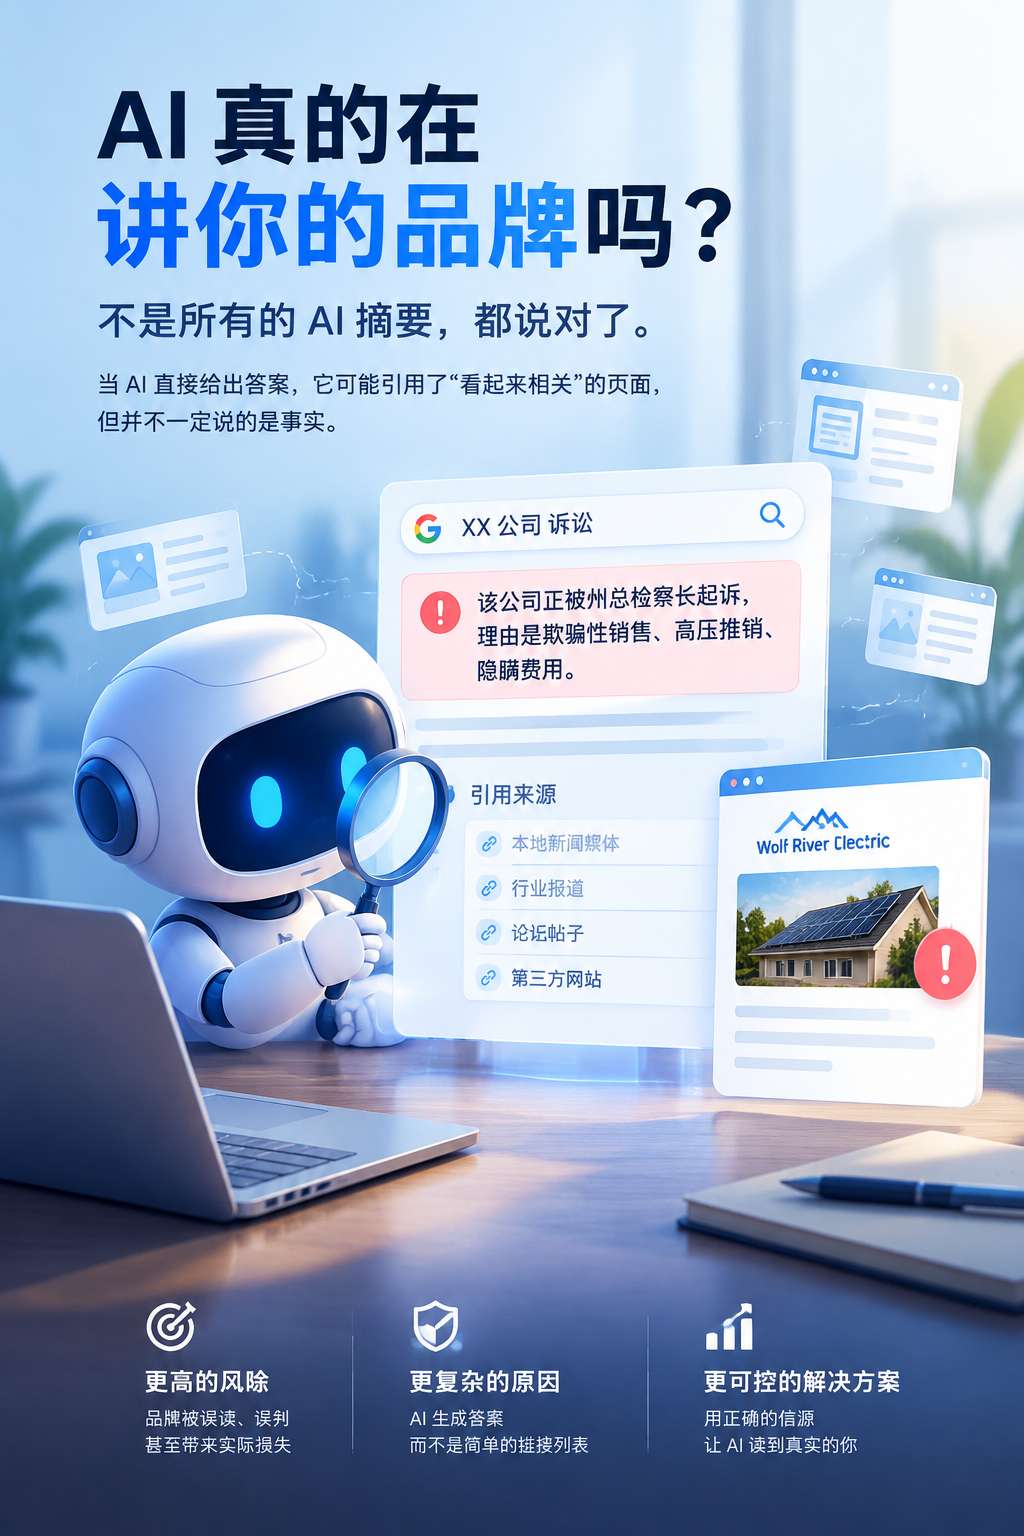
2024 年 9 月,美国明尼苏达州一家太阳能公司 Wolf River Electric 的员工发现:有人在 Google 上搜「Wolf River Electric 诉讼」,AI 摘要直接给出结论——这家公司正被州总检察长起诉,理由是”欺骗性销售、高压推销、隐瞒费用”。公司自己,完全不知道这回事。
几条摘要扩散之后,一笔 15 万美元的客户合同被取消。2025 年 3 月,这家公司把 Google 告上法庭,索赔 1.1 亿到 2.1 亿美元。[4]
法院文件里最扎眼的一句话是:AI 摘要引用的四个来源,没有一个支持”Wolf River 被起诉”这个说法。它引的那篇本地媒体报道,讲的是总检察长起诉的另外四家太阳能公司,只在文末顺带提了一句 Wolf River。[4]
这不是”AI 偶尔说错”。2026 年 10 月,两份新数据把这件事摊到了台面上。它们指向一笔很多品牌还没意识到的账:AI 怎么讲你,已经和你怎么讲自己,脱钩了。
01|AI 摘要是”写答案”,不是”挑链接”
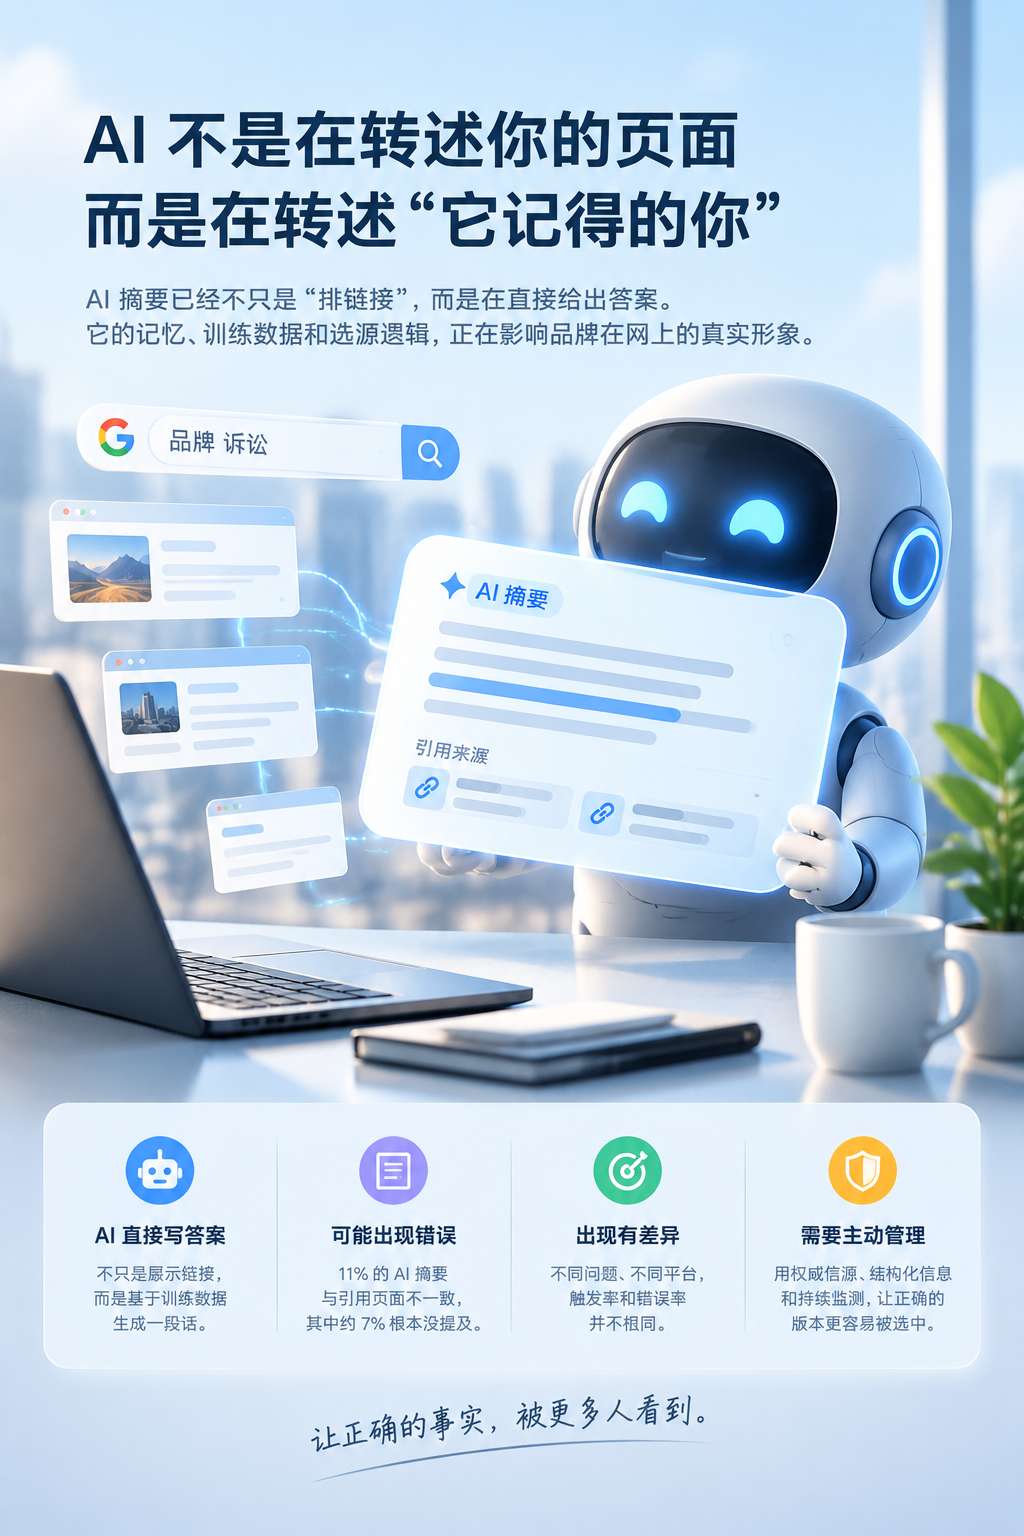
过去搜索给你一排链接,读哪条、信谁,你自己判断。现在 AI 摘要直接把一段话摆在最上面——它替你做完了判断。研究者把这件事说得很直白:Google 现在是在”写答案”,而不只是”排答案”,而且它是对数十亿次搜索这么做的。[1]
问题就出在这。生成式模型不是去”检索事实”,而是预测”最可能的下一串词”。Google 自己在 2026 年 10 月 1 日更新的官方指南里,第一次把这句话写进去:
“生成式模型不会去检索事实,而是基于训练数据预测一个可能的词序列……正因如此,生成式 AI 的输出可能包含不准确的内容(也就是幻觉)。”
它紧接着加了一句措辞很重的提醒:发布前对全部 AI 生成内容做人工核实,是“关键(critical)”的。[3]
这次点名的范围,还从正文扩到了标题(title 标签)、meta 描述、结构化数据和图片 alt 文本——这些”看着像技术字段”的东西,全都在模型可能讲错的范围里。[3]
更麻烦的是,AI 摘要并非均匀地出现在所有问题上。华盛顿大学的研究显示:爱好与休闲类搜索的触发率是 46.1%,科学类 39.9%,而政治类只有 7.5%、法律与政府类 9.6%。[1] 换句话说,它出现在哪些问题上,本身就是一套没有对外说明的裁量。
一句金句值得先记住:摘要不是在转述你的页面,它是在转述”它记得的你”。
02|两份大样本数据:品牌被讲错,有多普遍
第一份,来自圣路易斯华盛顿大学,将在 2026 年 10 月的 ACM 互联网测量大会(IMC)上发表,是目前针对 Google AI 摘要规模最大的独立审计。研究团队在 40 天里(2026 年 3 月 13 日到 4 月 21 日)跑了 55,393 条热门提问,覆盖 19 个领域。[1]
AI 摘要整体出现率:13.7%;但在”问句形式”的搜索里,升到 64.7%。[1]
这个落差很说明问题:问题问得越像”人话”,越容易撞上一段生成答案。 研究者还发现,非问句搜索里,一个词的提问只有约 9.9% 触发摘要,六个词以上的升到 38.7%。[1]
接下来是它拆”准确性”的方式。团队把摘要切成 98,020 条可核查的”原子事实”,逐条对着它引用的页面核对:
89% 有据可查;11% 对不上——其中约 7% 是引用页面根本没提这件事,约 4% 是摘要和引用来源自相矛盾。[1]
论文特别强调,”漏说”(引用页压根没提这句)才是最主流的失败方式。此外,只有 41.9% 的摘要做到了”每一条都能在引用页里找到依据”;29.8% 被引用的域名,压根没出现在同一页的传统搜索结果里——说明 AI 摘要有一套独立于排名的”选源逻辑”。[1]
还有一个反直觉的结论:来源质量和摘要准确性,基本是两回事。 团队发现,被 AI 摘要引用的域名,平均可信度评分反而高于同页的传统搜索结果;可信来源,却并不保证摘要将它转述得准确。[1]
第二份,来自 AI 可见性平台 Searchable 的品牌核对数据。截至 2026 年 7 月 29 日,1,704 个品牌核对了 32,556 条”AI 关于自己的陈述”,其中 9.2% 被判为错误;每 4 个品牌里,就有 3 个至少发现 1 条错。分平台看:ChatGPT 8.1%、Perplexity 11.5%、Google AI 摘要 11.4%。[2]
它最容易讲错的,恰好是客户最容易拿来决策的字段:价格、融资与财务、以及”它和哪些软件集成”。
小企业更吃亏:收到过”凭空编造事实”的小企业占 50%,大企业是 32%;把品牌名认错的,小企业 4%、大企业 0.7%。[2]
同一平台的另一组测试,针对 165 家伦敦企业问了 13,365 次:93% 的企业至少有一条基础事实被讲错或缺失;另一组高频门店测试里,每 16 条答案就有 1 条是错的,最常见的错误是邮编给错(约每 10 条地址答案错 1 条)。[2]
换成人话:品牌在 AI 嘴里的”错误率”,是个一位数,但踩中点就是一次事故。
03|为什么”改了官网”经常没用
因为 AI 讲错你,有两种完全不同的来源,改法也不一样。
一种是”实时检索型”:模型去网上搜,然后总结它找到的页面。这种错误通常能追溯到具体来源——页面旧了,或者几处信息互相打架。改源、等重新收录,几天到几周能见效。
另一种是”训练记忆型”:模型在没有联网的情况下,直接从训练数据里”回忆”。这部分错误,改网页改不动——它要等下一个模型版本才可能变,周期以月计。
一家监测服务商在 2026 年 10 月 2 日做过一组自测:在”不联网”模式下问自家公司,ChatGPT 把它当成一家养老金金融科技公司,Gemini 把它当成亚马逊广告代运营公司。两套答案都错。(服务商自测口径,仅作方向参考。)[5]
错误还分四类,修法各不同:
– 过时事实(旧价格、旧 CEO、关掉的店)→ 改自有页;
– 张冠李戴(和同名、同业公司被混在一起)→ 做实体消歧;
– 凭空编造(没有任何可追溯来源)→ 强化权威信源 + 长期监测;
– 继承负面(旧论坛帖、旧差评被当成现状)→ 用新内容把旧内容盖过去。
还有一条必须记住的边界:引用 ≠ 正确。 模型完全可以引一个”大致相关”的页面,来支撑它自己生成的那句话——引用看起来可信,内容却已经走样。[7] 这也是为什么”你的品牌被 AI 提到了”是个好消息,但它不等于”被讲对了”。
一个更冷的推论:对同一个品牌,不同 AI 可能给出互不相同的版本。一次干净,不代表次次干净。
自己动手 5 分钟也能验证:拿 3–5 条你品类的高频问题,分别在两三个 AI 里各问一遍,把答案和官网逐句对照,标出”说错 / 过期 / 缺项”。多数品牌第一次做,就会在价格、成立时间、业务范围这三类字段上踩到问题。
04|纠错的正确姿势:不是”投诉聊天机器人”,是”信源工程”
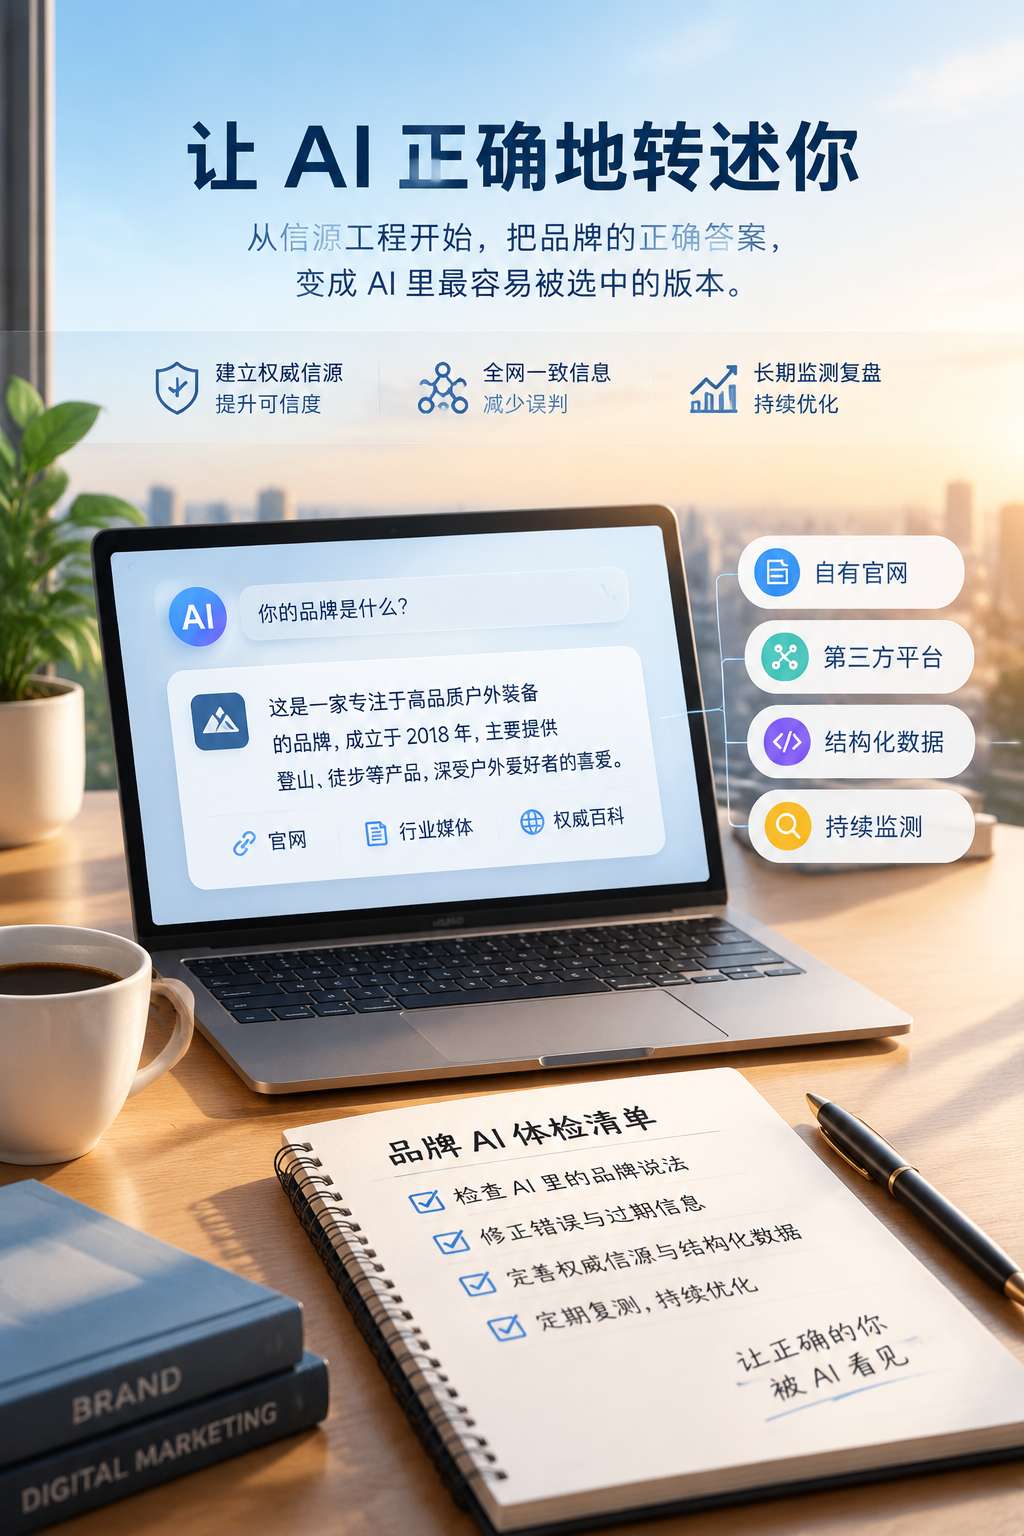
结论先说:你改不了那一条答案,你能改的是——让”正确版本”成为网上最权威、最一致、最可被引用的那个版本。 行业给出的落点是”信源与实体信号工程”,不是跟对话框较劲。[7]
给你一张可以照着走的 5 步表:
① 先记录,再分类。 把 prompt、平台、日期、截图、AI 引用的来源都存下来。有引用 → 多半是检索型,去改那一页;没引用、还反复出现 → 可能是记忆型,重点转向长期信号。
② 先改自有源。 About、产品、价格、FAQ 用”可见文本”写清,别把关键信息锁在图片、PDF 里。价格尤其要写明币种、计费周期、包含项,用真表格;改动后同步更新站点地图里的最后修改时间。
③ 再改高影响第三方。 Wikipedia / Wikidata 优先(它们同时喂训练数据和实时检索),再到领英、Crunchbase、行业目录;确保 NAP(名称 / 地址 / 电话)全网一致——不一致会让引擎把你识别成几家公司,实体一散,AI 就锚不住你。
④ 用结构化数据”声明事实”。 Organization / Product / FAQPage 等;硬规则只有一条——schema 里的值必须和页面可见文本完全一致,否则帮倒忙。用 sameAs 连官方主页做消歧。
⑤ 复测,该升级就升级。 改完回到同一批问题重问,看新答案有没有变;涉及价格、合规、健康、安全,或构成诽谤的错误,直接转法务,走平台正式申诉与来源更正渠道。
把上面四类错误,压成一张可以直接对号的小表:
| 你看到的现象 | 大概率归类 | 先修哪里 | 预期见效 |
|---|---|---|---|
| — | — | — | — |
| 旧价格 / 旧高管反复出现 | 过时事实·检索型 | 自有页 + 第三方目录 | 数天–数周 |
| 被安上别人家的业务 / 官司 | 张冠李戴·实体混淆 | 实体消歧 + 权威词条 | 数周–数月 |
| 无来源的、反复出现 | 凭空编造·记忆型 | 权威信源 + 长期监测 | 月级 |
| 拿旧差评当现状 | 继承负面 | 新证据型内容覆盖 | 数周 |
这里最关键的一句:纠错的目标不是”让那条答案消失”,而是”让正确版本成为检索时更容易被选中的那个”。
Google 10 月 1 日那次更新,其实顺手给了团队一个”内部评审政策”的官方依据:既然连标题、元描述、结构化数据、alt 都要人工核实,那”AI 生成 + 人工过一遍”就应该是标准流程,而不是可选项。[3]
总结:把”被 AI 讲对”当成一项可运营的资产
把这几件事串起来看,逻辑很清楚:
热度是别人给的,答案是自己攒的。 AI 摘要替品牌写”官方介绍”的比例在涨,但它引用你的前提,是它在别处先读到了关于你的、一致而权威的说法。”改了官网没用”,不是因为官网不重要,而是因为纠错从来不是单点动作,而是把正确的事实铺成一张互相印证的网。
可以落地的三件事:
– 定期做一次”AI 问询体检”:把品类高频问题拿去问几个主流 AI,记录”被提及 / 被说错 / 被忽略”,尤其盯错误率;
– 把事实写成”机器能拿走的样子”:直接、结构化、和 schema 一致;
– 让第三方替你说话:一级垂直平台、测评、目录、权威词条,比自说自话更有用。
最后留一个判断:AI 摘要的错误率,研究自己都标注了”是上限”(论坛、视频里的内容没有被完整采集)。也就是说,真实情况可能更好,也可能更麻烦。但方向是确定的——品牌在 AI 里的”说法”,正在变成一件需要被管理、被复测、被记账的事。[1]
写在最后
过去做品牌,最难的是”让更多人知道你”;现在多了一层,是”让机器正确地转述你”。前者靠传播,后者靠信源。两件事的度量方式不同,负责的人却常常是同一批人。
如果你的品牌最近搜索量在涨、但咨询里开始出现”AI 说你们……”这类奇怪问题,那基本可以确定:不是流量问题,是信源问题。先做一次问询体检,比继续加投放更划算。
如果你想把自家品牌在 AI 眼里的”说法”系统盘一遍,可以后台回复关键词「体检表」,领取我们整理好的《品牌 AI 搜索资产体检表》(Excel + 说明文档,可直接编辑填写)——里面有提问清单模板、AI 问询记录表(含”被说错 / 过期”判定)、错误率算法,以及一张 90 天行动清单。
引用与参考资料:
[1] Xu, Iqbal & Montgomery,*Measuring Google AI Overviews: Activation, Source Quality, Claim Fidelity, and Publisher Impact*,被 2026 ACM Internet Measurement Conference(IMC)接收,DOI: 10.1145/3777912.3839818;数据经圣路易斯华盛顿大学新闻稿(Sara Savat)转述(digitalinformationworld,2026-10-05)及 Agentic Tribune(2026-10-05)报道交叉核对。
[2] Searchable,*The AI Brand Misinformation Report*(数据截止 2026-07-29,32,556 条 / 1,704 品牌);伦敦企业测试(13,365 次提问 / 165 家企业)经 Retail Focus、Resultsense(2026-07-16)、Netzender(2026-07-20)、Stanislav Peev 统计汇编交叉核对。
[3] Google Search Central《使用生成式 AI 内容的指南》(2026-10-01 更新);经 Search Engine Land(2026-10-02)、Search Engine Journal(2026-10-02)、Search Engine Roundtable(2026-10-02)、PPC Land(2026-10-02)多方一致报道交叉核对。
[4] *LTL LED, LLC d/b/a Wolf River Electric et al v. Google LLC*,案号 0:2025cv02394,美国明尼苏达州地区法院;起诉状与移卷文件(CourtListener,2025);《Star Tribune》(2025-06-13)报道。
[5] Vercatus,*AI Answers Show Wrong Information About Our Brand*(2026 年 10 月,服务商自测口径)。
[6] EBU / BBC《News Integrity in AI Assistants》(2025-10,22 家公共广播机构、18 国、3,000+ 答案);经 wiszniewsky.pl(2026-09-26)转述(二手来源)。
[7] Onely《How to Fix Incorrect AI Brand Information》(2026-09-28);Reputation Ace(2026-10-03);AI GEO Insights(2026-09-29);Vercatus(纠错方法论部分)。
> 注:以上 [5][6][7] 为服务商 / 从业者自述口径,仅作方向参考,不构成独立效果背书;Searchable、Vercatus 数据为平台自报,存在商业立场。
免责声明:
本文基于公开资料整理与分析,所引数据、结论均尽量标注来源并交叉核对;行业服务商 / 平台自报口径已在文中与参考资料中注明,不代表绝对基准。文中案例与法律进展信息以公开报道与法院文件为准,可能随时间更新。本文仅供品牌与营销从业者参考交流,不构成法律、投资或经营建议。如涉及具体品牌的商誉、合规或法律问题,请咨询专业机构。