一个月内,三个地方同时对 AI 生成广告动手了。
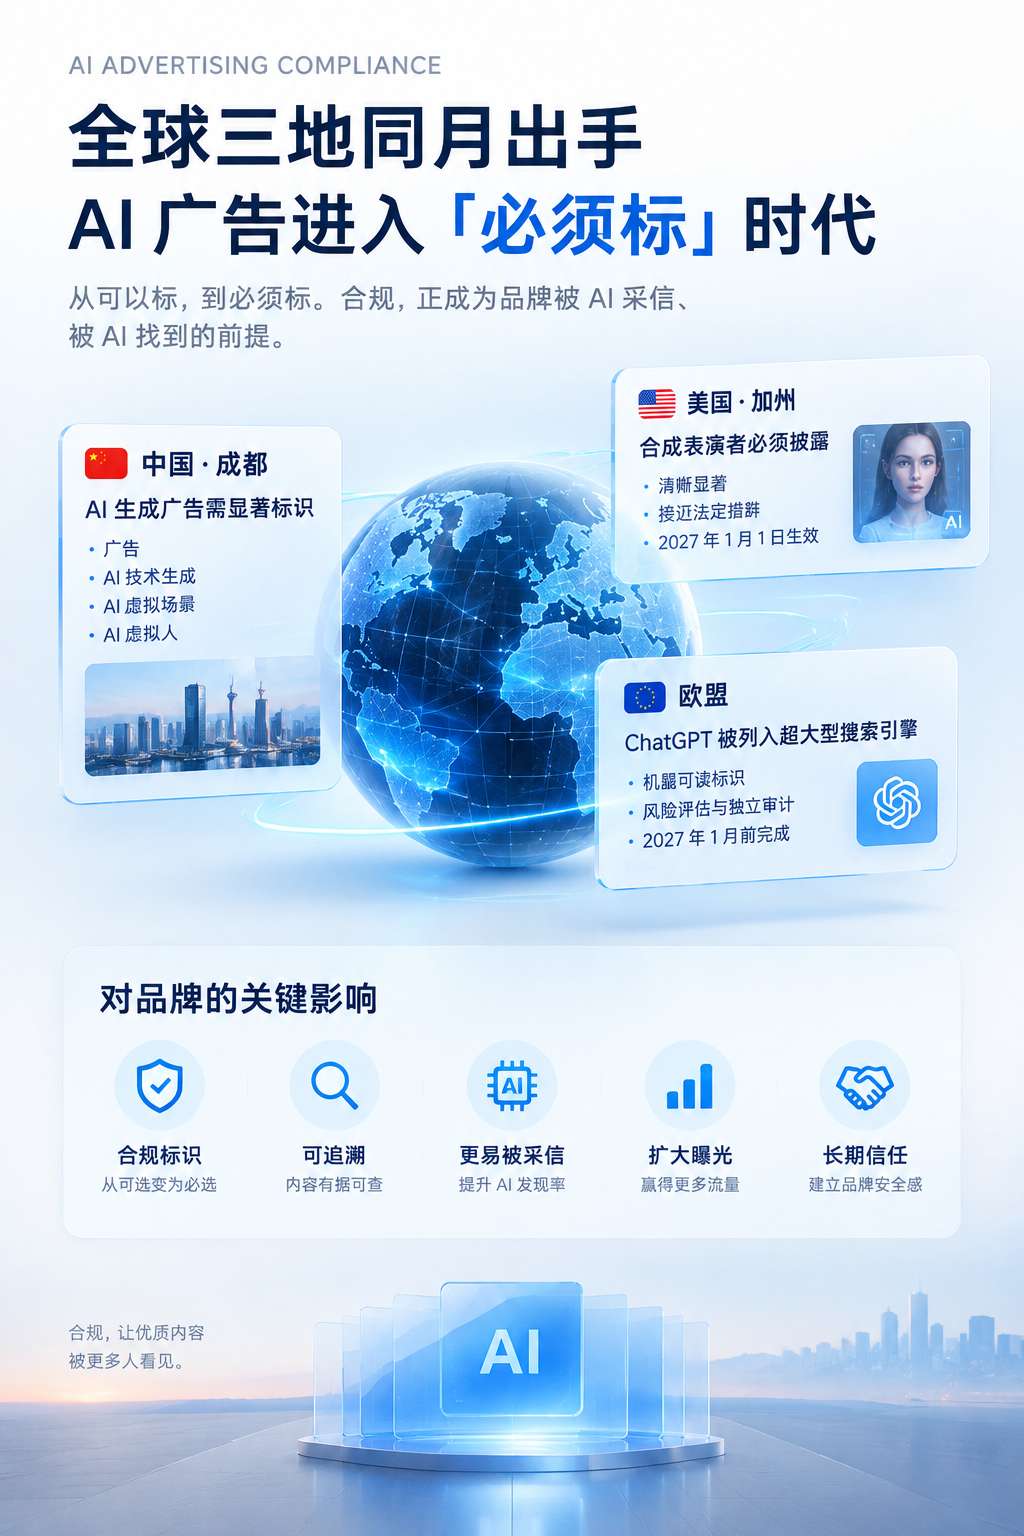
9 月 18 日,成都市市场监督管理局发布《AI 生成广告合规指引》:AI 生成广告除了依法标明「广告」,还要加标「本广告由 AI 技术生成」「本广告含 AI 虚拟场景」「AI 虚拟人」这类字样[1]。这是中西部地区第一份专门冲着 AI 广告来的合规指引[1]。
9 月 16 日,美国加州州长签署 SB 1050:广告里只要「显著」出现 AI 合成的「表演者」,就必须清晰、显著地披露,措辞要接近「本表演由合成表演者出演」或「画面中没有真人出演」[2]。
同月,欧盟把 ChatGPT 正式列入「超大型在线搜索引擎」,并要求生成式内容带上机器可读的标识[4]。
把它们放在一起看,信号只有一句话:AI 生成的内容,从「可以标」变成了「必须标」。
对品牌来说,这不只是法务的事。它正在悄悄改写一条更前面的规则——你的内容能不能合规,越来越决定它能不能被 AI 采信、被 AI 找到。
01|一个月内,三地同时给 AI 广告「上标签」
先把时间线摆清楚。
国内,落点在「广告」。 成都这份指引把 AI 生成广告界定为:用 AI 生成或合成、用于推销商品或服务的文本、图片、音频、视频、虚拟场景、AI 虚拟人、真人虚拟数字形象等[1]。它覆盖四件事——概念与适用主体、标识标注、负面清单、主体责任[1]。配套的监管数据也很直接:2026 年以来,成都共监测互联网广告 68 万条次,处置涉嫌违法线索 2429 条次,查处违法案件 358 件,罚没 165 万元[1]。
美国,落点在「表演者」。 加州 SB 1050 针对的是「合成表演者」——用生成式 AI 造出的、像真人却不指向任何具体真人的数字形象、声音或表演[2]。法案要求广告创作者使用法定接近的措辞作出「清晰而显著」的披露,2027 年 1 月 1 日生效[2]。加州之前,纽约已于 2026 年 6 月 9 日实施了全美第一部同类法律[3]。
欧盟,落点在「功能」。 欧盟委员会没有等 AI 专项立法成熟,而是看 ChatGPT「做了什么」——检索实时网页并总结成答案,功能上就是搜索,于是按现行《数字服务法》(DSA)把它认定为「超大型在线搜索引擎」,须在 2027 年 1 月前补齐系统性风险评估、独立审计等义务[4]。此前,欧盟《人工智能法案》的透明度规则已于 2026 年 8 月 2 日起适用,要求机器可读地标记 AI 生成或修改的内容[4]。
三地路径不同,但都指向同一件事:判断标准不是「你用没用 AI」,而是「用户能不能识别出这是 AI」。
02|国内这份指引,给品牌列了四张责任清单
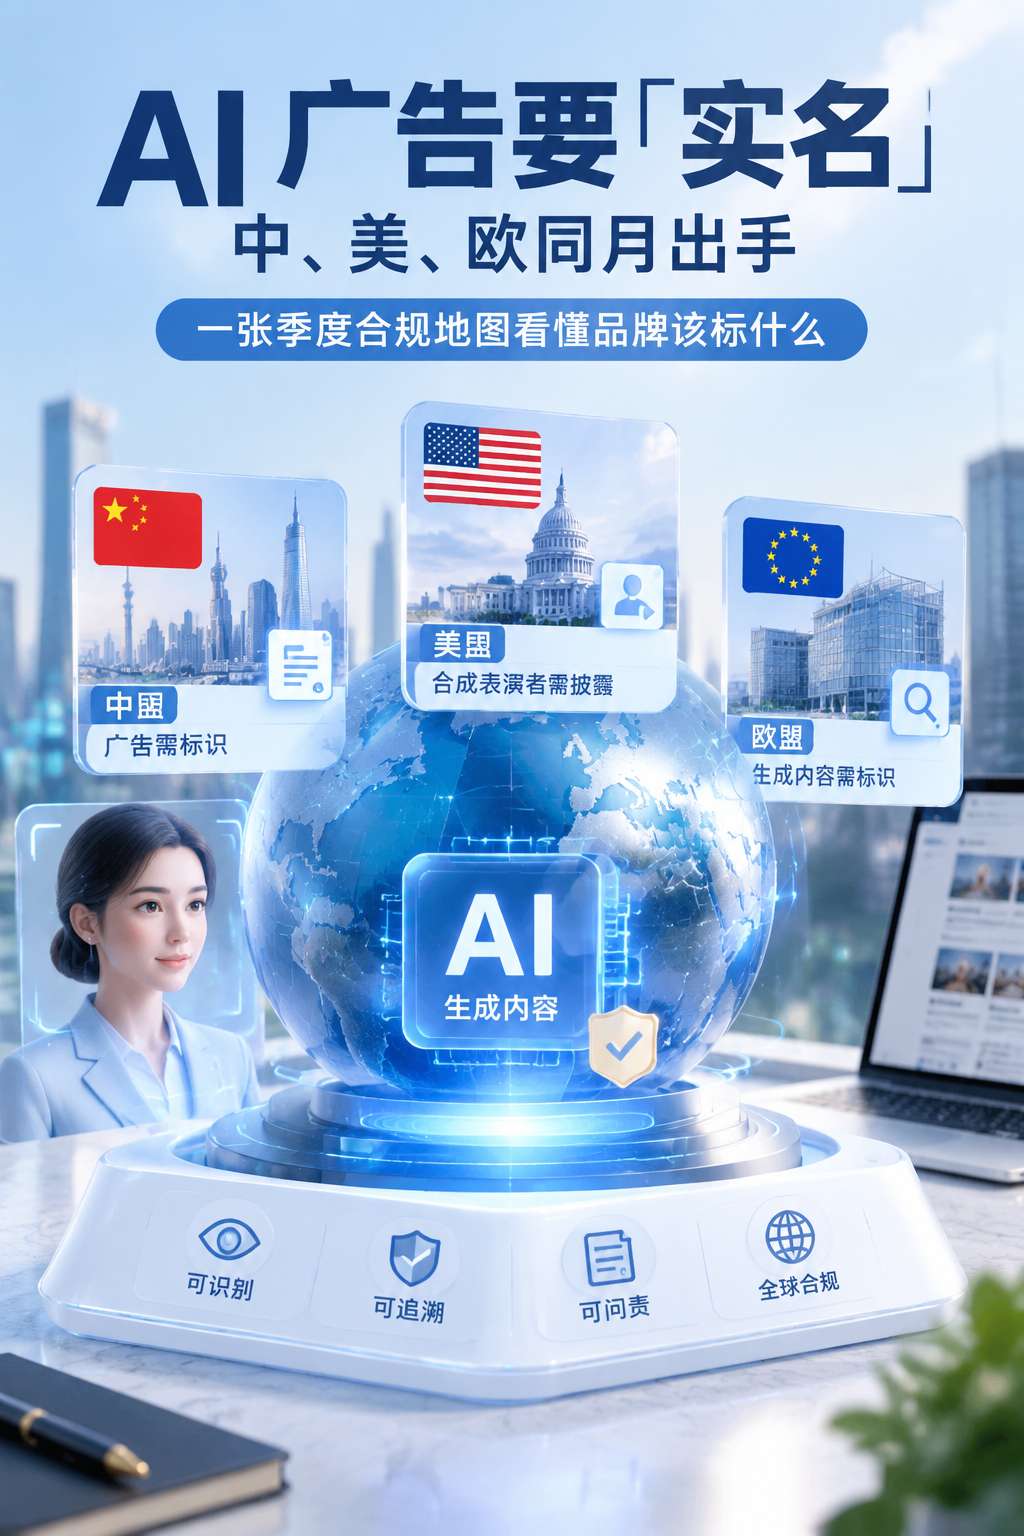
成都这份指引最值得品牌人抄作业的,是它把「谁该做什么」拆得很细。
第一张,谁被管。 不只管广告主,还包括广告经营发布主体、互联网平台、MCN 机构、主播、自媒体运营主体、AI 生成服务提供者[1]。只要你在成都辖区内用 AI 做商业广告内容,就在射程内。 这一条把过去常被当成「平台问题」的责任,拉回到了品牌和内容团队自己身上。
第二张,标什么。 除「广告」字样外,指引给出了几种标识措辞:如「本广告使用 AI 技术辅助优化」「广告画面经 AI 处理」「本广告含 AI 虚拟场景」「本广告由 AI 技术生成」「本广告使用 AI 虚拟人」「本广告使用真人虚拟数字形象」等[1]。关键不是措辞本身,而是「显著清晰、防止混淆与误导」这个标准——标识不能藏在角落,也不能含糊到用户看不出。
第三张,负面清单。 明确了几条红线:未经同意,不得利用 AI 生成合成可识别特定自然人的虚拟数字形象用于广告营销;不得在广告中声称 AI 虚拟人对商品或服务的使用体验;不得利用 AI 生成合成低俗等内容用于广告营销[1]。「AI 虚拟人说自己用过」这类话术,被直接点名。
第四张,谁负责。 广告主对内容的真实性、合法性负责;广告经营者与发布者要建立承接登记、审核、档案管理制度,鼓励对 AI 广告做标签化管理;平台要建治理体系、拦截违法广告、配合执法;AI 生成服务提供者要按《生成式人工智能服务管理暂行办法》《人工智能生成合成内容标识办法》等做好标识[1]。此外,对医疗、药品、保健食品、金融理财、教育培训、未成年人产品等重点领域,鼓励设置更严格的审核[1]。
一句话概括这份指引的思路:把「AI 标识」从一个可选项,变成审核流程里的一道必答题。
03|美国和欧盟在管什么:两条完全不同的路子
如果说国内是把 AI 标识嵌进广告审核,那么美国和欧盟,走的是另外两条路。
美国走「州法 + 具体场景」。 纽约和加州盯的都是「合成表演者」这一个点:广告里出现 AI 造的人,必须披露[2][3]。两法还互相补位——纽约不覆盖纯音频广告,加州覆盖了;加州给了法定措辞,纽约没给;加州还允许私人诉讼[2]。动机也很直白:既保护消费者不被「像真人的假人」误导,也回应演员工会对「AI 替代真人」的关切[2][3]。
欧盟走「按功能分类 + 按风险分级」。 它对 ChatGPT 的处理很有代表性:不纠结它是不是「平台」,而是看它做的事——检索、总结、给出答案——像不像搜索,像就按搜索管[4]。同时,《人工智能法案》用「透明度 + 机器可读标识」覆盖更广的 AI 生成内容[4]。这套逻辑下,同一个产品可能同时面对两个监管口子,各管一段[4]。
把三种路子并列:
– 中国:显式标识 + 隐式标识,强调全链路可追溯、主体责任分层;
– 美国:聚焦广告披露场景,州法先行、行业(工会)推动、罚则可诉;
– 欧盟:按功能归入既有法规,按风险分级叠加义务。
路径不同,落点却高度一致:可识别、可追溯、可问责。 这三条,正在成为 AI 时代内容的基础门槛。
04|对品牌真正的影响:合规,正在变成「被 AI 找到」的前置条件
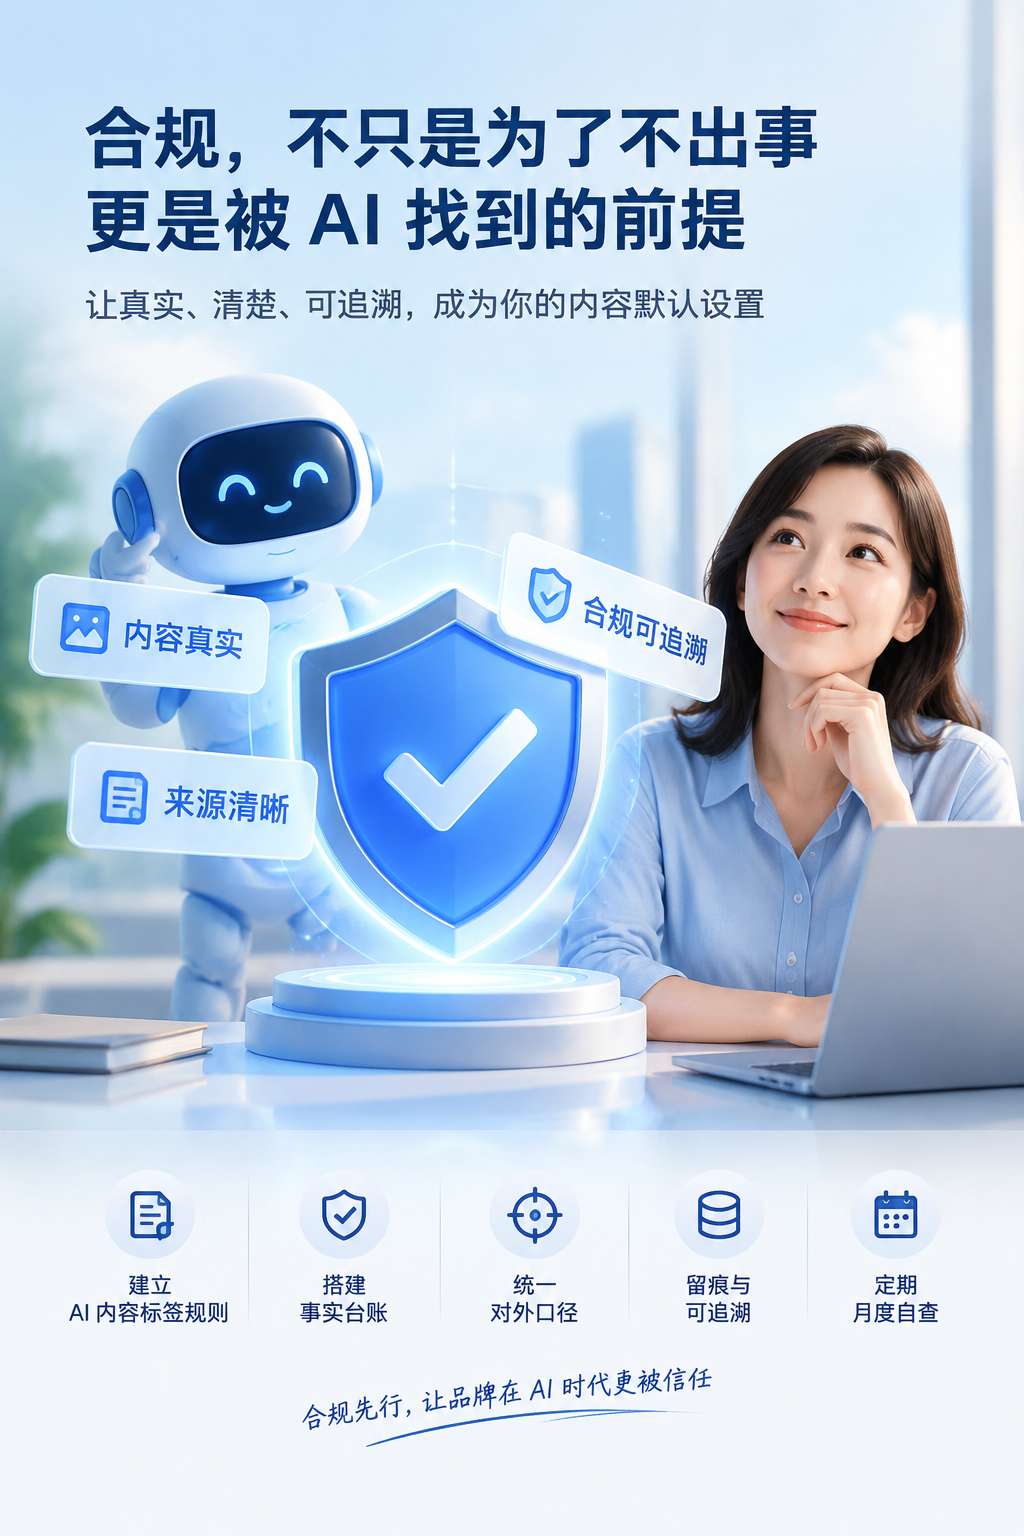
很多品牌会觉得:这是合规部门的事,跟增长有什么关系?
关系比想象中紧。回到我们第六期一直在讲的主线——品牌能不能被 AI 找到、被 AI 引用,取决于 AI 从哪里取信。
先看一个上游事实。2026 年 9 月 2 日,中央网信办公布「清朗」专项行动第二阶段进展:聚焦利用 AI 制作虚假信息、假冒仿冒他人、侵害未成年人权益等突出问题,累计清理违法违规信息 561 万余条,查处账号 4.9 万余个,处置违规网站、应用程序 2400 余个[5]。被清理的不是「AI 生成」,而是虚假、仿冒、违规、未履行标识的那一类。
这件事和「被 AI 找到」直接相关。一项覆盖 100 个品牌、652 条来源的最新分析发现:品牌自己名下的页面,只贡献了 AI Overviews 引用来源的 29%,其余 71% 来自新闻媒体、视频、维基、社区、点评、竞品等第三方[6]。另一项针对 AI 购物助手的研究发现,同一个购物问题,不同 AI 助手给出的品牌清单差异极大,美国时尚品类里最被推荐的品牌也只占到 7% 的「货架份额」[7]。
这两组数据合起来说明:AI 是在一个由多方信源拼成的证据池里,挑它认为可信的内容。 在这个池子里——
– 口径统一、来源清楚、可核验的内容,更容易被采信;
– 违规、仿冒、来路不明的内容,不仅可能被平台清理,还可能被模型归入低质信源,长期压低你的可见性。
也就是说,合规不是「被 AI 找到」的对立面,而是它的地基。 你的内容越经得起追问(谁发的、依据是什么、何时有效、由谁确认),AI 越敢引用你。
基于这套逻辑,品牌可以按五步先把合规底座搭起来:
1. 建「AI 内容标签规则」。 明确哪类物料用了 AI 生成或合成(数字人、AI 配音、AI 场景图),对应加什么标识,写进制作规范,而不是发布前临时补。
2. 建事实台账。 产品的功效、参数、认证,各自绑定一份可核验材料;案例说明主体与授权;数据标明统计口径。AI 和监管都在找「依据」,你就把依据提前备好。
3. 统一对外口径。 官网、公众号、电商详情页、第三方媒体的同一事实,措辞尽量一致。口径越乱,AI 越难确认哪个是你。
4. 留痕与可追溯。 保留素材来源、授权记录、审核记录和版本记录。留痕不只是应对监管,也是应对「AI 错误引用」时的纠错依据。
5. 月度自查。 重点行业(医疗、金融、教育、未成年人产品等)按更严标准过一遍;普通行业也别把合规留到最后一步。
05|写在最后
这一轮三地同月出手,最值得记住的不是某一条法规,而是它背后的方向转变:
过去,合规是「别出事」的成本;现在,合规是「被相信」的前提。
在一个 AI 替用户筛选信息的时代,一条内容能不能被找到,越来越取决于它经不经得起核验。你越早把「真实、清楚、可追溯」做成内容的默认设置,越早拿到被 AI 采信的那张入场券。
合规做在前面,成本最低;等规则和审核都压过来,成本最高。
一句话思考题:如果明天 AI 用一套最严格的合规标准来读你现有的内容,它读得出几成是真的、几成有据可查?
如果你想把自家品牌在 AI 眼里的「得体程度」先盘一遍,可以公众号后台回复关键词「体检表」,领取我们整理好的《品牌 AI 搜索资产体检表》(Excel + 说明文档,可直接编辑填写)。
引用与参考资料:
[1] 成都市市场监督管理局《AI 生成广告合规指引》,2026-09-18 发布(经川观新闻、凤凰网等报道,含标识要求、负面清单、主体责任及 2026 年成都互联网广告监管数据)。https://cbgc.scol.com.cn/news/7968803 https://news.ifeng.com/c/8wWsUodBkm4
[2] California SB 1050(False advertising: synthetic performers),2026-09-16 由州长签署,2027-01-01 生效;Davis+Gilbert LLP 解读。https://www.gov.ca.gov/2026/09/16/governor-newsom-signs-new-law-to-protect-workers-require-disclosures-on-ai-generated-advertising/ https://www.dglaw.com/california-becomes-second-state-to-require-disclosure-of-synthetic-performers-in-advertising/
[3] New York synthetic performer disclosure law(2025 年 12 月签署,2026-06-09 生效)。https://www.governor.ny.gov/news/governor-hochul-announces-first-nation-law-requiring-disclosure-when-advertisements-include-ai
[4] 欧盟委员会将 ChatGPT 认定为「超大型在线搜索引擎」(2026-08-31,依据《数字服务法》);《人工智能法案》透明度规则自 2026-08-02 起适用。https://www.gerrishlegal.com/blog/chatgpt-is-now-regulated-as-a-search-engine-in-the-eu-what-that-means-for-ai-enabled-software https://eastflank.eu/eu-policy/analysis/the-eu-considers-chatgpt-a-search-engine-but-strict-rules-may-miss-its-most-important-part
[5] 中央网信办「清朗」专项行动第二阶段工作通报,2026-09-02(累计清理违法违规信息 561 万余条、查处账号 4.9 万余个、处置违规网站与应用程序 2400 余个)。https://www.cac.gov.cn/2026-09/02/c_1790099041364574.htm
[6] Slate Research, “AI Overviews for Brand Searches: 100 Brands Analyzed”, 2026-10-01(100 个品牌、652 条引用来源;品牌自有域名占 29%,其余 71% 来自第三方)。https://slatehq.com/blog/ai-overviews-brand-searches
[7] Jellyfish, “AI Shopping Upends the Rules of Brand Leadership…”, 2026-10-01(Share of Model 购物优化研究,覆盖美英澳新八类目、多个 AI 助手)。https://martechseries.com/predictive-ai/ai-platforms-machine-learning/ai-shopping-upends-the-rules-of-brand-leadership-price-positioning-competition-according-to-new-jellyfish-research/
免责声明:
本文基于公开报道与官方公开信息整理,旨在进行行业观察与方法讨论,不构成任何法律、投资、投放或采购建议。文中涉及的法规条款、时间节点以官方发布为准,具体合规判断请咨询专业法律意见并结合自身业务独立核实。文中第三方数据(如 Slate、Jellyfish 等)多来自研究机构或服务商的自报口径,存在商业立场,未作独立效果背书。如涉版权或事实出入,请联系我们更正。